Синтез речи (TTS): полное руководство по озвучке текста естественным голосом (2026)
За несколько лет синтез речи прошёл путь от роботизированного голоса до почти человеческого. В этом руководстве: как работает TTS, для чего его используют, как подготовить текст, чтобы он звучал естественно, как ответственно пользоваться ИИ-голосами и как за секунды превратить любой текст в голосовое сообщение.
Коротко: синтез речи (TTS) превращает письменный текст в звучащую речь. Ещё несколько лет назад он звучал как робот, а сегодняшние ИИ-голоса дышат, делают паузы и меняют интонацию, как человек. С ним можно слушать вместо того, чтобы читать, озвучить видео, тренировать язык или отправить голосовое, не записывая себя. С Telegram-ботом вроде heymesbot вы вставляете текст и через несколько секунд получаете естественное голосовое сообщение.
В этом руководстве
Что такое TTS и как создаются ИИ-голоса
Шесть повседневных применений
Восемь советов для естественного звучания
Как выбрать сервис озвучки
Ответственное использование ИИ-голосов
Озвучка текста прямо в Telegram
Что такое синтез речи?
Синтез речи — это программа, которая читает письменный текст вслух синтезированным голосом. Его называют также озвучкой текста или text to speech (TTS), а в приложениях он встречается как «прочитать вслух», «генератор голоса» или «ИИ-голос».
Его легко спутать с двумя соседями:
Распознавание речи (голосовой ввод, диктовка) работает наоборот: превращает сказанное в текст.
Клонирование голоса создаёт копию голоса конкретного человека по его записям. Обычный TTS вместо этого использует готовые голоса.
Эти и многие другие термины объяснены в нашем словаре терминов ИИ.
Как работает синтез речи: от робота к живому голосу
TTS прошёл три больших поколения.
Конкатенативный синтез резал записи диктора на крошечные фрагменты и склеивал их заново. Звучало разборчиво, но стыки были слышны, а чтобы сменить голос или эмоцию, приходилось записывать всю базу заново.
Параметрический синтез строил речь по статистической модели. Он был гибким, но звучал глухо и монотонно.
Нейросетевой синтез изменил всё. В 2016 году WaveNet от DeepMind начал генерировать звуковую волну напрямую, отсчёт за отсчётом, и в слепых тестах сократил разрыв между лучшими системами того времени и человеческой речью более чем вдвое. В 2017 году Tacotron 2 от Google соединил сеть, которая предсказывает характеристики звука по тексту, с «вокодером» в стиле WaveNet и достиг естественности, сравнимой с профессиональной записью.
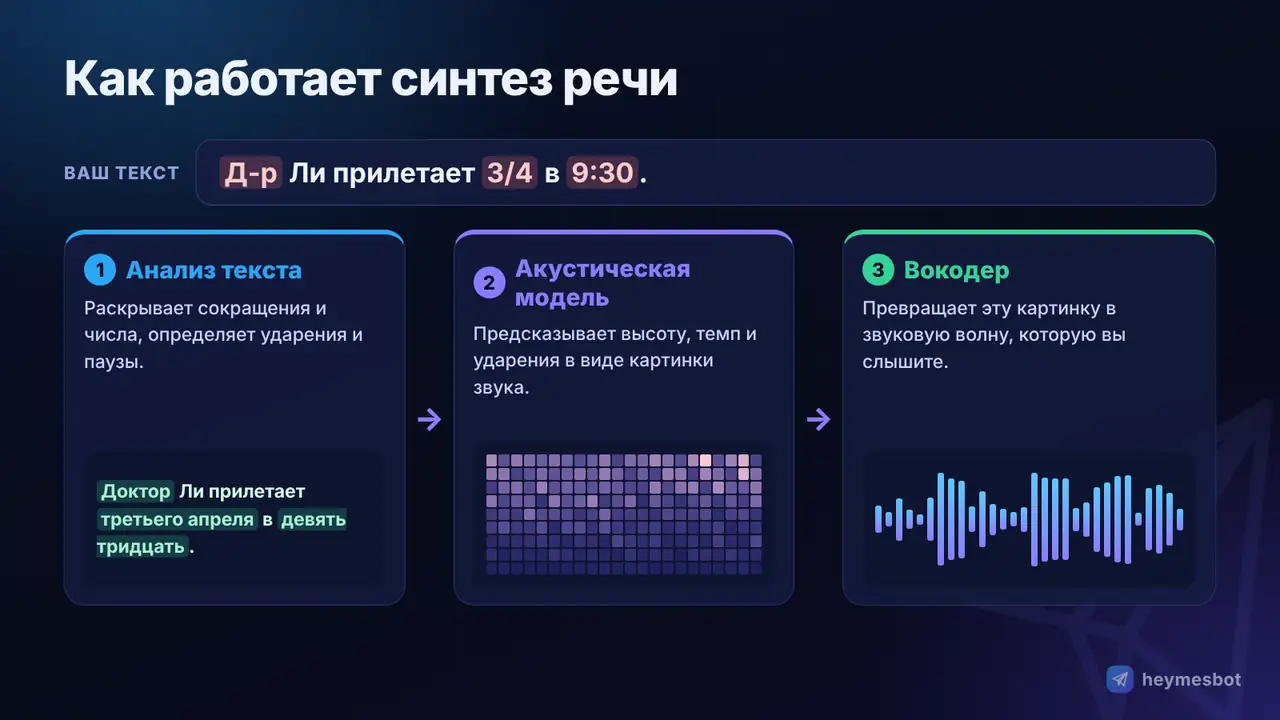
Большинство современных систем по-прежнему проходят три шага:
Анализ текста. Текст очищается и раскрывается: «д-р» становится «доктор», «2026» — «две тысячи двадцать шесть», система определяет произношение, ударения и места пауз.
Акустическая модель. Нейросеть предсказывает, как должна звучать речь: высоту тона, темп, ударения и интонацию — обычно в виде спектрограммы (картинки звука).
Вокодер. Вторая сеть превращает эту картинку в настоящую звуковую волну, которую вы слышите.
Новейшие голоса построены на той же технологии больших языковых моделей, что и ИИ-чаты (см. Что такое искусственный интеллект и как он работает), поэтому лучше понимают контекст: вопрос действительно звучит как вопрос, а перечисление — как перечисление.
Для чего используют синтез речи
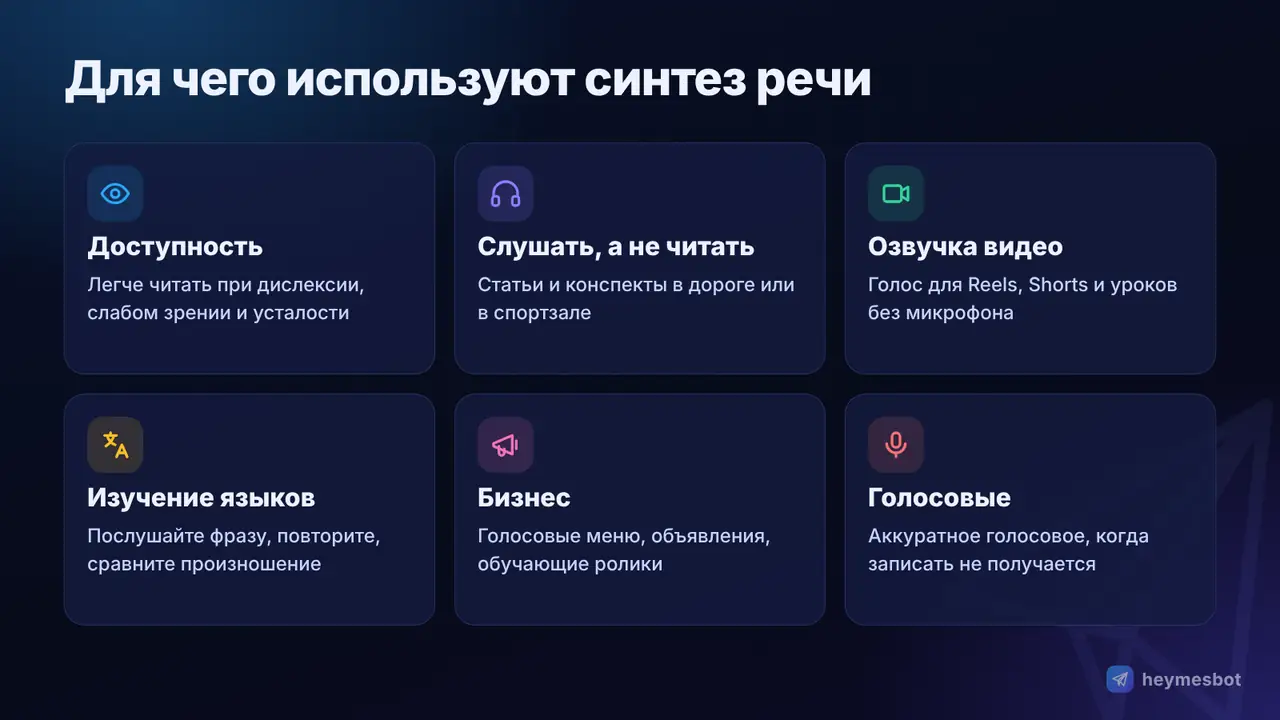
Доступность. Людям с дислексией, слабым зрением или усталостью от чтения слушать текст одновременно с чтением заметно проще, объясняет организация Understood, занимающаяся особенностями обучения.
Слушать вместо чтения. Длинные статьи, конспекты и заметки превращаются в аудио для дороги, спортзала или кухни.
Озвучка видео. Reels, Shorts, обучающие ролики и видео о товарах получают чистый закадровый голос без микрофона и тихой комнаты.
Изучение языков. Слушайте, как звучит фраза, повторяйте и сравнивайте своё произношение.
Бизнес и объявления. Голосовые меню, объявления в магазине, обучающие ролики и презентации продукта одним узнаваемым голосом.
Сообщения, которые не записать. Отправьте аккуратное голосовое, когда вокруг шумно, вы стесняетесь своего голоса или пишете на языке, на котором не говорите свободно.
Восемь советов для естественного звучания
Голос — только половина дела; вторая половина — текст, который вы ему даёте. Текст, который хорошо читается глазами, не всегда хорошо звучит вслух.
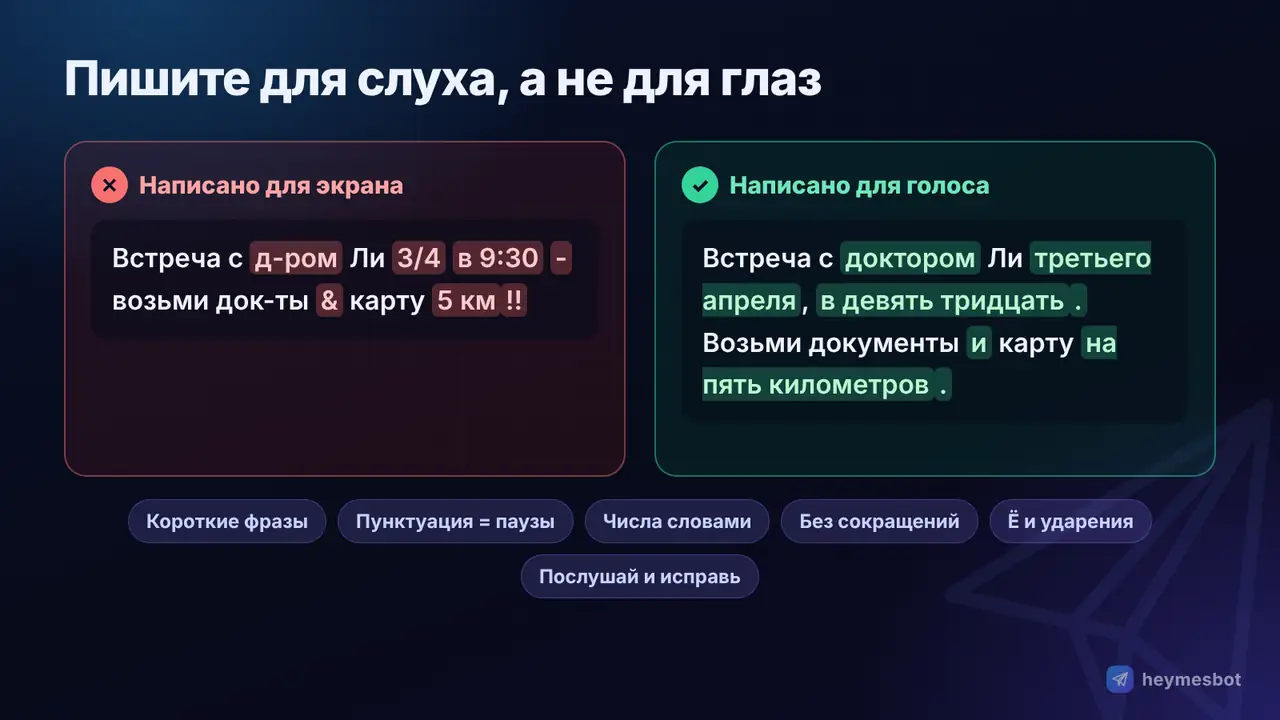
Пишите для слуха. Короткие предложения и простые слова: слушатель не может перемотать назад глазами.
Управляйте паузами пунктуацией. Запятая даёт короткую паузу, точка — длиннее. Вопросительный знак меняет интонацию, ставьте его только в настоящих вопросах.
Пишите числа, даты и единицы так, как их нужно произнести. «3/4» неоднозначно, «третьего апреля» — нет. «5 км» понятнее как «пять километров».
Раскрывайте сокращения и символы. «т. е.», «и т. д.», «&» или «%» могут прочитаться странно; пишите «то есть», «и так далее», «и», «процентов».
Помогите с ударениями. «Замок» может быть и за́мком, и замко́м, «все» и «всё» — разные слова. Ставьте букву ё и знак ударения или перестройте фразу так, чтобы смысл был очевиден.
Один язык на текст. Переключение языков посреди фразы может сменить акцент. Иностранные названия пишите просто, по возможности кириллицей.
Подбирайте голос под содержание. Спокойный низкий голос подходит для медитации или документального видео, яркий и весёлый — для рекламы или поздравления.
Слушайте перед публикацией и делите длинные тексты. Сгенерируйте версию, прослушайте, исправьте неудачные фразы и попробуйте снова. Короткие фрагменты проще исправлять.
Профессиональные студии идут дальше с SSML — языком разметки W3C, где можно точно задать паузы, ударения и произношение. Для повседневных задач советов выше обычно достаточно. О том, как давать ИИ понятные инструкции, читайте в нашем гайде по составлению промптов.
Как выбрать сервис озвучки текста
| Вариант | Качество звука | Что вы получаете | Цена и усилия |
|---|---|---|---|
| Встроенная читалка (телефон, компьютер, браузер) | Разборчиво, но часто механически | Читает экран вслух; обычно без аудиофайла | Бесплатно, ничего не нужно ставить |
| Облачный TTS для разработчиков | Очень естественно | Аудиофайлы через API | Оплата за символы; нужны программирование и банковская карта |
| Онлайн-студии озвучки | Очень естественно, много функций | Файлы, редактор, библиотеки голосов | Обычно ежемесячная подписка |
| heymesbot в Telegram | Естественные ИИ-голоса, 10 на выбор | Голосовое сообщение Telegram, готовое к пересылке и сохранению | 0,03 TON за сообщение, без подписки и установки |
Правильный выбор зависит от объёма. Если вы каждую неделю делаете часы аудио, подписка на студию может окупиться. Если нужно то голосовое, то озвучка ролика, платить за каждое сообщение в приложении, которое и так открыто, проще.
Ответственное использование ИИ-голосов
ИИ-голоса — мощный инструмент, поэтому важны несколько правил:
Никогда не клонируйте и не имитируйте голос реального человека без его разрешения. Федеральная торговая комиссия США (FTC) предупреждает, что мошенники с помощью клонирования голоса подделывают звонки от «попавших в беду» родственников. Если вам срочно звонят и просят деньги, положите трубку и перезвоните человеку по номеру, который знаете сами.
Сообщайте аудитории, что голос сгенерирован ИИ. Например, правила использования OpenAI требуют ясно сообщать слушателям, что они слышат ИИ-голос.
Соблюдайте правила контента. Сервисы ИИ-голосов не озвучивают ненавистнические, обманные или откровенные тексты.
heymesbot использует только готовые ИИ-голоса и не копирует голос реальных людей.
Озвучка текста в Telegram с heymesbot
heymesbot приносит естественные ИИ-голоса в мессенджер, который у вас и так открыт, — без установки приложений и без подписки:
Откройте бота по ссылке t.me/heymesbot и нажмите Start.
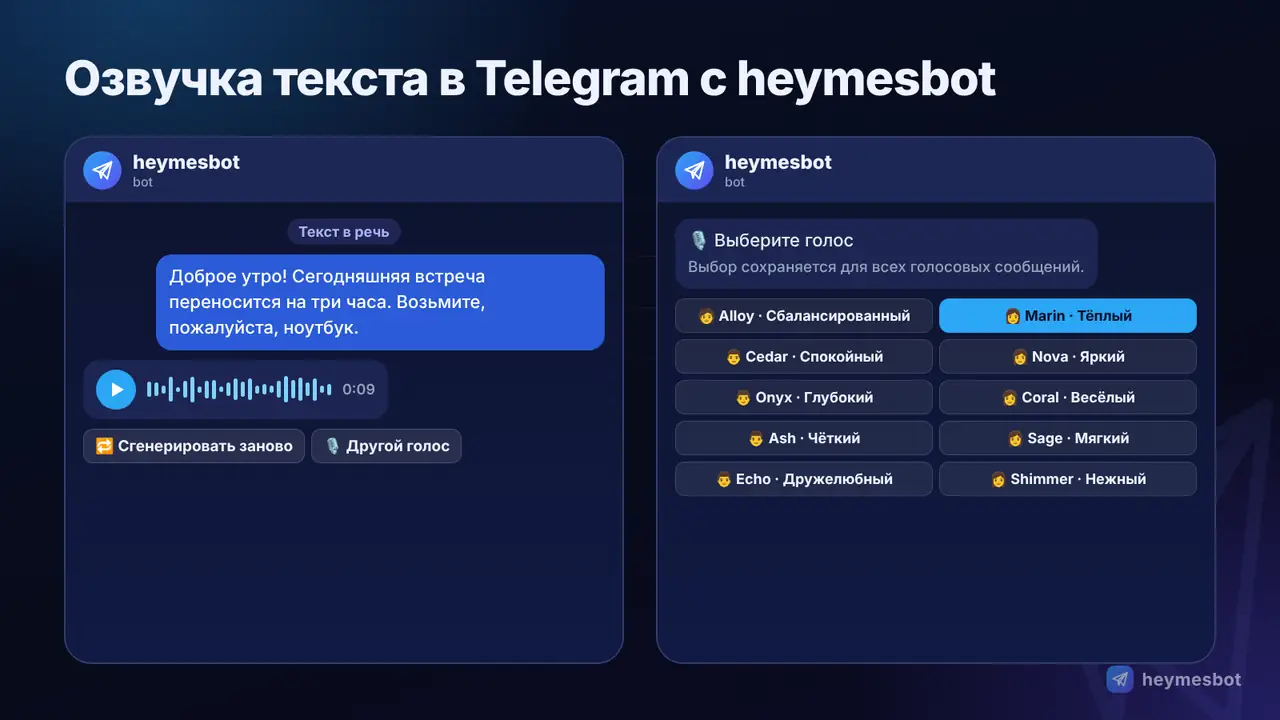
Нажмите «Текст в речь» в меню или просто напишите что-то вроде «прочитай вслух: …».
Отправьте текст — до 1000 символов (примерно минута речи), на русском или любом другом языке.
Получите голосовое сообщение Telegram через несколько секунд. Под ним кнопка 🔁 Сгенерировать заново делает новый дубль, а 🎙️ Другой голос открывает выбор голосов.
Выберите голос один раз. Голосов десять: Alloy (сбалансированный), Marin (тёплый), Cedar (спокойный), Nova (яркий), Onyx (глубокий), Coral (весёлый), Ash (чёткий), Sage (мягкий), Echo (дружелюбный) и Shimmer (нежный). Выбор запоминается для всех следующих сообщений.
Бонус для тех, кто пользуется чатом: под каждым ответом ИИ-чата в heymesbot есть кнопка 🔊 Прослушать, чтобы услышать ответ, а не читать его.
Цена: каждое голосовое сообщение стоит фиксированные 0,03 TON, кнопка «Прослушать» — столько же, и оплата списывается, только когда голосовое до вас дошло. Пополнение — в TON (Gram) из любого TON-кошелька; пошагово об этом в статье как купить Gram и пополнить heymesbot. Этот же бот общается, создаёт и редактирует картинки, делает видео и пишет музыку — см. полный гайд по нейросетям в Telegram.
Попробуйте прямо сейчас
Выберите текст, который приятнее слушать, чем читать: абзац конспекта, подпись к следующему ролику или сообщение другу. Отправьте его боту — меньше чем через минуту он будет у вас голосовым сообщением, тем голосом, который вам нравится.
Подробнее: страница озвучки текста и полный прайс.
Комментарии
Комментариев пока нет. Будьте первым.
Оставить комментарий
Комментарии появляются после проверки. Пожалуйста, по теме и вежливо.